INF Project
Informationsinfrastruktur und SciOps für reproduzierbare Wissenschaft
Das INF-Projekt wird die Zusammenarbeit zwischen den Teilprojekten des SFB1315 weiter fördern und die Fähigkeit des CRC 1315-Konsortiums zur Integration von Daten aus Versuchen an Menschen, Nagetieren und Fliegen weiter ausbauen, um neurowissenschaftliche Erkenntnisse und klinische Anwendungen zu generieren. Wir werden auf der Infrastruktur für das Forschungsdatenmanagement (Speicherung, Dokumentation, Verarbeitung, Weitergabe und Veröffentlichung) aufbauen, die vom Konsortium in Phase 2 entwickelt und genutzt wurde. Wir werden weiterhin Tools und Schulungen bereitstellen, um die konsistente Organisation von speziesübergreifenden multiskaligen neurowissenschaftlichen Daten und Modellen in einem gemeinsamen Referenzraum zu ermöglichen. Das INF-Teilprojekt ist von zentraler Bedeutung für den SFB. Es hat sich in Phase 2 regelmäßig mit den SFB-Teilprojekten beraten und wird diesen regen Austausch in Phase 3 fortsetzen. In Phase 2 hatten wir zwei Schwerpunkte. Erstens richtete er sich auf unsere internen Datenmanagementkapazitäten, d. h. wir implementierten Tools für das Datenmanagement heterogener Datensätze innerhalb des Konsortiums, boten Schulungen und Support zur Pflege eines aktuellen Datenmanagementplans (DMP) an und informierten über die Veröffentlichung von Forschungsergebnissen, die über klassische Zeitschriftenbeiträge hinausgehen, wie z. B. Datensätze, Software, Reagenzien und Hardware. Zweitens haben wir uns an lokalen, nationalen und internationalen Datenmanagement-Aktivitäten beteiligt und diese geleitet, wobei wir aktiv zur Entwicklung neuer Standards und Best Practices für den Austausch von Forschungsobjekten und für die Durchführung zuverlässiger und reproduzierbarer Forschung beigetragen haben. Das INF-Projekt hat zur Produktion von FAIR-Daten (Findable, Accessible, Interoperable, Reusable) in unserem Konsortium geführt. Wissenschaftliche Entdeckungen durch Wissensintegration durch die Formalisierung von Wissen als computergestützte Modelle, die simuliert werden können und falsifizierbare Vorhersagen in Bezug auf die Gedächtniskonsolidierung generieren. In der dritten Förderperiode planen wir – neben der Fortsetzung der Wartung der Datenmanagement-Infrastruktur und der Schulung der Konsortiumsmitglieder im Bereich Datenmanagement – die Fähigkeiten unserer Konsortiumsmitglieder in Bezug auf die Grundsätze einer strengen wissenschaftlichen Arbeitsweise zu verbessern, um einen höheren Reifegrad zu erreichen, der die Einführung neuer, technologiegestützter Methoden und Best Practices erfordert. Dazu gehören digitale Forschungsumgebungen, die rechnergestützte, automatisierte und KI-gesteuerte Prozesse nahtlos in den gesamten Forschungszyklus integrieren – vom Versuchsaufbau über die Datenerhebung bis hin zur Analyse und Verbreitung – und letztlich zu einem geschlossenen Forschungszyklus führen. Das Teilprojekt INF wird das Konsortium somit weiterhin auf dem Weg zu mehr Effizienz und Effektivität in der wissenschaftlichen Forschung begleiten.
Graphical Abstract
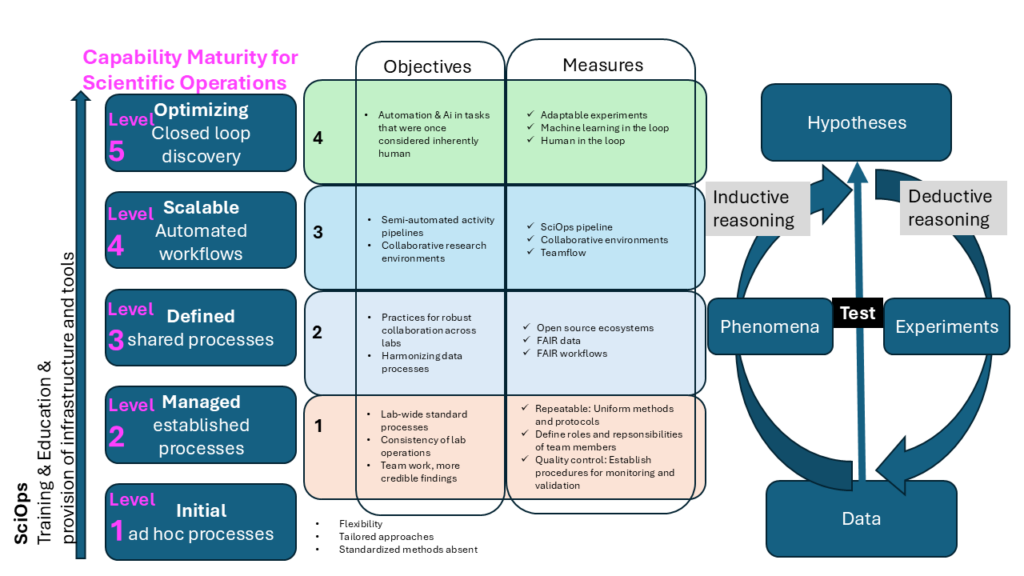
Graphic abstract: The scientific discovery loop towards an understanding of memory consolidation is supported by the INF project through fostering the proficiency for Science Operations according to the Capability Maturity Model for Science Operations ‘SciOps’ (Johnson et al. 2024).
Principal Investigators
-
Prof Dr med Petra Ritter
Charité – Universitätsmedizin Berlin
Head of the Section Brain Simulation (CCM) (Alumna PI B06)
-
Prof Matthew Larkum PhD
Humboldt-Universität zu Berlin
Spokesperson, Head Larkum Lab
-
Anna Nasr
Humboldt-Universität zu Berlin
INF PhD (A04 Associated PhD)
-
Shouvik Paul
Berlin Institute of Health at Charité (BIH)
INF PhD
-
Dr Marc Sacks
Charité – Universitätsmedizin Berlin
INF Alumnus Postdoc
-
Dr Julien Colomb
Humboldt-Universität zu Berlin
Alumnus, INF (2019-2022)
Publications
Combining cloud and Git tools in a research data management strategy for team science
Julien Colomb, Robert Mies
Bausteine FDM. 1;1-10 (2026)
Homeodynamic feedback inhibition control in whole-brain simulations
Jan Stasinski, Halgurd Taher, Jil Mona Meier, M Schirner, Dionysios Perdikis, Petra Ritter
PLoS Comput Biol 20:e1012595 (2024)
Personalized Connectome-Based Modeling in Patients with Semi-Acute Phase TBI: Relationship to Acute Neuroimaging and 6 Month Follow-Up
Tyler Good, Michael Schirner, Kelly Shen, Petra Ritter, Pratik Mukherjee, Brian Levine and Anthony Randal McIntosh
eNeuro. 9(1) (2022)
Pre- and post-surgery brain tumor multimodal magnetic resonance imaging data optimized for large scale computational modelling
Hannelore Aerts, Nigel Colenbier, Hannes Almgren, Thijs Dhollander, Javier Rasero Daparte, Kenzo Clauw, Amogh Johri, Jil Meier, Jessica Palmer, Michael Schirner, Petra Ritter & Daniele Marinazzo
Sci Data. 9, 676 (2022)
Analysis of acute COVID-19 including chronic morbidity: protocol for the deep phenotyping National Pandemic Cohort Network in Germany (NAPKON-HAP)
Fridolin Steinbeis, Charlotte Thibeault, Sarah Steinbrecher, Yvonne Ahlgrimm, Ira an Haack, Dietrich August, Beate Balzuweit, Carla Bellinghausen, Sarah Berger, Irina Chaplinskaya-Sobol, Oliver Cornely, Patrick Doeblin, Matthias Endres, Claudia Fink, Carsten Finke, Sandra Frank, Sabine Hanß, Tim Hartung, Johannes Christian Hellmuth, Susanne Herold, Peter Heuschmann, Jan Heyckendorf, Ralf Heyder, Stefan Hippenstiel, Wolfgang Hoffmann, Sebastian Ulrich Kelle, Philipp Knape, Philipp Koehler, Lucie Kretzler, David Manuel Leistner, Jasmin Lienau, Roberto Lorbeer, Bettina Lorenz-Depiereux, Constanze Dorothea Lüttke, Knut Mai, Uta Merle, Lil Antonia Meyer-Arndt, Olga Miljukov, Maximilian Muenchhoff, Moritz Müller-Plathe, Julia Neuhann, Hannelore Neuhauser, Alexandra Nieters, Christian Otte, Daniel Pape, Rafaela Maria Pinto, Christina Pley, Annett Pudszuhn, Philipp Reuken, Siegberg Rieg, Petra Ritter, Gernot Rohde, Maria Rönnefarth, Michael Ruzicka, Jens Schaller, Anne Schmidt, Sein Schmidt, Verena Schwachmeyer, Georg Schwanitz, Werner Seeger, Dana Stahl, Nicole Stobäus, Hans Christian Stubbe, Norbert Suttorp, Bettina Temmesfeld, Sylvia Thun, Paul Triller, Frederik Trinkmann, Istvan Vadasz, Heike Valentin, Maria Vehreschild, Christof von Kalle, Marie von Lilienfeld-Toal, Joachim Weber, Tobias Welte, Christian Wildberg, Robert Wizimirski, Saskia Zvork, Leif Erik Sander, Janne Vehreschild, Thomas Zoller, Florian Kurth & Martin Witzenrath
Infection. 52, 93–104 (2024)
Virtual brain simulations reveal network-specific parameters in neurodegenerative dementias
Anita Monteverdi, Fulvia Palesi, Michael Schirner, Francesca Argentino, Mariateresa Merante, Alberto Redolfi, Francesca Conca, Laura Mazzocchi, Stefano F. Cappa, Matteo Cotta Ramusino, Alfredo Costa, Anna Pichiecchio, Lisa M. Farina, Viktor Jirsa, Petra Ritter, Claudia A.M. Gandini Wheeler-Kingshott, Egidio D’Angelo
Front Aging Neurosci. 15:1204134 (2023)
The Past, Present, and Future of the Brain Imaging Data Structure (BIDS)
Russell A. Poldrack, Christopher J. Markiewicz, Stefan Appelhoff, Yoni K. Ashar, Tibor Auer, Sylvain Baillet, Shashank Bansal, Leandro Beltrachini, Christian G. Benar, Giacomo Bertazzoli, Suyash Bhogawar, Ross W. Blair, Marta Bortoletto, Mathieu Boudreau, Teon L. Brooks, Vince D. Calhoun, Filippo Maria Castelli, Patricia Clement Alexander L. Cohen, Julien Cohen-Adad, Sasha D’Ambrosio, Gilles de Hollander, María de la Iglesia-Vayá, Alejandro de la Vega, Arnaud Delorme, Orrin Devinsky, Dejan Draschkow, Eugene Paul Duff, Elizabeth DuPre, Eric Earl, Oscar Esteban, Franklin W. Feingold, Guillaume Flandin, Anthony Galassi, Giuseppe Gallitto, Melanie Ganz, Rémi Gau, James Gholam, Satrajit S. Ghosh, Alessio Giacomel, Ashley G. Gillman, Padraig Gleeson, Alexandre Gramfort, Samuel Guay, Giacomo Guidali, Yaroslav O. Halchenko, Daniel A. Handwerker, Nell Hardcastle, Peer Herholz, Dora Hermes, Christopher J. Honey, Robert B. Innis, Horea-Ioan Ioanas, Andrew Jahn, Agah Karakuzu, David B. Keator, Gregory Kiar, Balint Kincses, Angela R. Laird, Jonathan C. Lau, Alberto Lazari, Jon Haitz Legarreta, Adam Li, Xiangrui Li, Bradley C. Love, Hanzhang Lu, Eleonora Marcantoni, Camille Maumet, Giacomo Mazzamuto, Steven L. Meisler, Mark Mikkelsen, Henk Mutsaerts, Thomas E. Nichols, Aki Nikolaidis, Gustav Nilsonne, Guiomar Niso, Martin Norgaard, Thomas W. Okell, Robert Oostenveld, Eduard Ort, Patrick J. Park, Mateusz Pawlik, Cyril R. Pernet, Franco Pestilli, Jan Petr, Christophe Phillips, Jean-Baptiste Poline, Luca Pollonini, Pradeep Reddy Raamana, Petra Ritter, Gaia Rizzo, Kay A. Robbins, Alexander P. Rockhill, Christine Rogers, Ariel Rokem, Chris Rorden, Alexandre Routier, Jose Manuel Saborit-Torres, Taylor Salo, Michael Schirner, Robert E. Smith, Tamas Spisak, Julia Sprenger, Nicole C. Swann, Martin Szinte, Sylvain Takerkart, Bertrand Thirion, Adam G. Thomas, Sajjad Torabian, Gael Varoquaux, Bradley Voytek, Julius Welzel, Martin Wilson, Tal Yarkoni, and Krzysztof J. Gorgolewski
Imaging Neurosci (Camb). 8;2:1-19 (2024)
A lesion-aware automated processing framework for clinical stroke magnetic resonance imaging
Patrik Bey, Kiret Dhinds, Amrit Kashyap, Michael Schirner, Jan Feldheim, Marlene Bönstrup, Robert Schulz, Bastian Cheng, Götz Thomalla, Christian Gerloff, Petra Ritter
bioRxiv (2023)
Whole-brain modeling of the differential influences of amyloid-beta and tau in Alzheimer’s disease
Gustavo Patow, Leon Stefanovski, Petra Ritter, Gustavo Deco, Xenia Kobeleva and for the
Alzheimer’s Disease Neuroimaging InitiativeAlz Res Therapy. 15, 210 (2023)
Scale-free functional brain networks exhibit increased connectivity, are more integrated and less segregated in patients with Parkinson’s disease following dopaminergic treatment
Orestis Stylianou, Zalan Kaposzta, Akos Czoch, Leon Stefanovski, Andriy Yabluchanskiy, Frigyes Samuel Racz, Petra Ritter, Andras Eke, Peter Mukli
Fractal Fract. 6(12):737 (2022)
White-matter degradation and dynamical compensation support age-related functional alterations in human brain
Spase Petkoski, Petra Ritter, Viktor K Jirsa
Cereb Cortex. 33(10):6241-6256 (2023)
A deep learning approach to estimating initial conditions of Brain Network Models in reference to measured fMRI data
Amrit Kashyap, Sergey Plis, Petra Ritter and Shella Keilholz
Front. Neurosci. 17:1159914 (2023)
Evolution and adoption of contributor role ontologies and taxonomies
Mohammad Hosseini, Julien Colomb, Alex O. Holcombe, Barbara Kern, Nicole A. Vasilevsky, Kristi L. Holmes
Learn Publ. (2022)
Dynamic primitives of brain network interaction
Michael Schirner, Xiaolu Kong, B.T. Thomas Yeo, Gustavo Deco, Petra Ritter
NeuroImage. 250:118928 (2022)
Overcoming the Reproducibility Crisis – Results of the first Community Survey of the German National Research Data Infrastructure for Neuroscience
Carsten M. Klingner, Michael Denker, Sonja Grün, Michael Hanke, Steffen Oeltze-Jafra, Frank W. Ohl, Janina Radny, Stefan Rotter, Hansjörg Scherberger, Alexandra Stein, Thomas Wachtler, Otto W. Witte, Petra Ritter
bioRxiv (2022)
Research data management in clinical neuroscience: the national research data infrastructure initiative
Carsten M. Klingner, Petra Ritter, Stefan Brodoehl, Christian Gaser, André Scherag, Daniel Güllmar, Felix Rosenow, Ulf Ziemann und Otto W. Witte
Neuroforum. 27(1):35-43 (2021)
NFDI-Neuro: Building a community for neuroscience research data management in Germany
Thomas Wachtler, Pavol Bauer, Michael Denker, Sonja Grün, Michael Hanke, Jan Klein, Steffen Oeltze-Jafra, Petra Ritter, Stefan Rotter, Hansjörg Scherberger, Alexandra Stein und Otto W. Witte
Neuroforum. 27(1):3-15 (2021)
Brain simulation as a cloud service: The Virtual Brain on EBRAINS
Michael Schirner, Lia Domide, Dionysios Perdikis, Paul Triebkorn,...., Agnes Flöel, ...Jochen Mersmann, Viktor Jirsa, Petra Ritter
NeuroImage. 251:118973 (2022)
Virtual deep brain stimulation: Multiscale co-simulation of a spiking basal ganglia model and a whole-brain mean field model with The Virtual Brain
Jil M. Meier, Dionysios Perdikis, André Blickensdörfer, Leon Stefanovski, Qin Liu, Oliver Maith, Helge Ü. Dinkelbach, Javier Baladron, Fred H. Hamker, Petra Ritter
Exp Neurol. 354:114111 (2022)
The importance of standards for sharing of computational models and data
Russell A. Poldrack, Franklin Feingold, Michael J. Frank, Padraig Gleeson, Gilles de Hollander, Quentin JM Huys, Bradley C. Love, Christopher J. Markiewicz, Rosalyn Moran, Petra Ritter, Timothy T. Rogers, Brandon M. Turner, Tal Yarkoni, Ming Zhan, Jonathan D. Cohen
Comput Brain & Behav. 2(3-4):229-232 (2019)